Masz dobry tekst, ale nie wiesz, czy rzeczywiście obejmuje temat lepiej niż strony konkurencji? TF-IDF pomaga ocenić, które słowa są charakterystyczne dla dokumentu na tle całego zbioru, a w SEO może ułatwić znalezienie brakujących pojęć, tematów i kontekstów. Pokażę, jak działa ten wskaźnik, jak interpretować jego wyniki oraz dlaczego nie należy traktować go jako instrukcji do mechanicznego upychania fraz.
Najważniejsze informacje o analizie TF-IDF
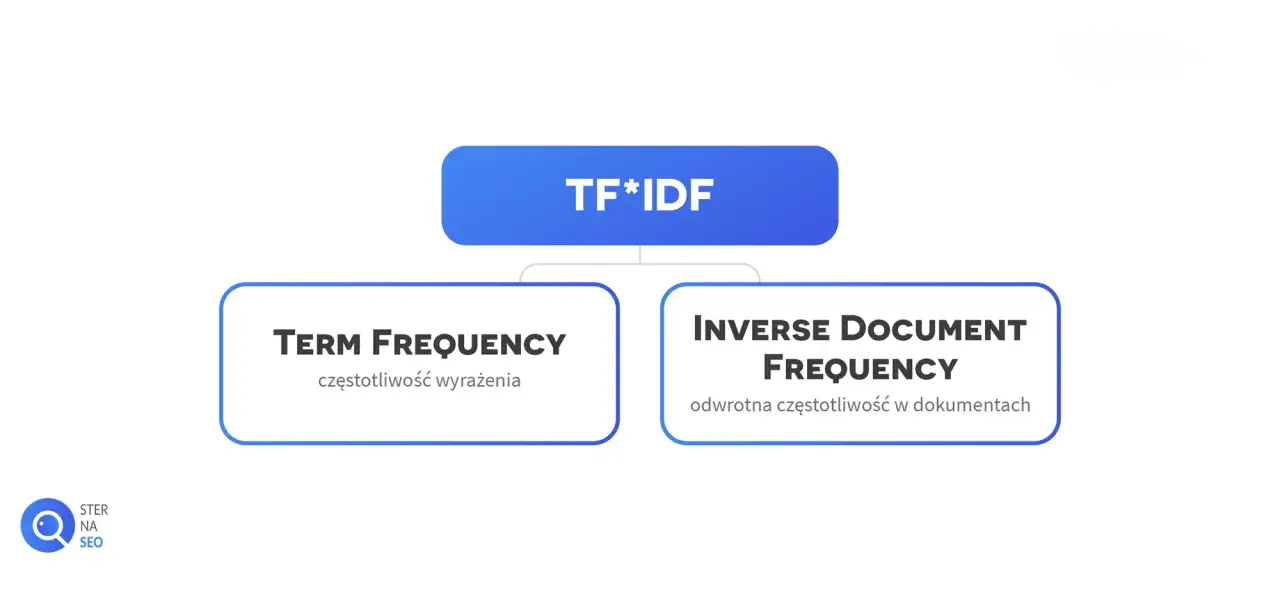
- TF mierzy częstotliwość występowania słowa w jednym dokumencie.
- IDF pokazuje, jak rzadki jest termin w całym analizowanym zbiorze.
- Wysoki wynik nie oznacza automatycznie, że tekst jest lepszy ani wyżej oceniany przez Google.
- W SEO analiza pomaga wykrywać brakujące pojęcia i konteksty, a nie ustalać idealną liczbę powtórzeń słowa kluczowego.
- Największe znaczenie ma jakość porównywanego zbioru stron oraz zgodność ich intencji z Twoim tekstem.
Czym jest TF-IDF i co naprawdę mierzy
TF-IDF to statystyczna metoda oceny, jak ważne jest dane słowo dla konkretnego dokumentu w porównaniu z większą kolekcją dokumentów. W praktyce łączy dwie informacje: jak często termin pojawia się w tekście oraz jak często występuje w innych tekstach.
TF, czyli częstotliwość terminu
TF, od term frequency, opisuje udział danego słowa w jednym dokumencie. Najprostszy wariant oblicza się jako liczbę wystąpień terminu podzieloną przez liczbę wszystkich słów w tekście. Jeżeli słowo „audyt” występuje 8 razy w artykule liczącym 1000 słów, jego częstotliwość wynosi 0,008.
Sam wysoki TF nie mówi jeszcze, że termin jest szczególnie wartościowy. Słowa takie jak „SEO”, „strona” czy „tekst” mogą pojawiać się często, ponieważ są naturalną częścią tematu, ale nie muszą odróżniać jednego dokumentu od drugiego.
IDF, czyli rzadkość w zbiorze
IDF, od inverse document frequency, koryguje ten problem. Im mniej dokumentów zawiera dane słowo, tym wyższa jego wartość informacyjna. Popularny zapis wygląda tak: IDF = log(N / df), gdzie N oznacza liczbę wszystkich dokumentów, a df liczbę dokumentów zawierających analizowany termin.
Jeśli słowo występuje niemal na każdej stronie w badanym zbiorze, jego IDF spada. Jeżeli pojawia się tylko w kilku dokumentach, wynik rośnie. Końcowa wartość powstaje przez połączenie obu elementów, najczęściej według wzoru TF-IDF = TF × IDF.
To dlatego wskaźnik nie nagradza wyłącznie częstego powtarzania słowa. Szuka raczej terminów, które są częste w jednym dokumencie, ale stosunkowo rzadkie w całym zbiorze.
Jak rozumieć wynik w praktyce SEO
W analizie SEO nie interesuje mnie sama liczba przy słowie. Znacznie ważniejsze jest to, co ta liczba sugeruje o zakresie tematycznym tekstu. Jeżeli konkurencyjne strony regularnie poruszają pojęcia „indeksowanie”, „crawl budget” i „mapa witryny”, a Twój artykuł ich nie wspomina, może to wskazywać na lukę merytoryczną.
Nie oznacza to jednak, że trzeba dopisać wszystkie brakujące terminy. Najpierw sprawdzam, czy rzeczywiście pasują do intencji czytelnika. Artykuł o podstawach SEO nie musi rozwijać zaawansowanej konfiguracji serwera tylko dlatego, że takie słowo ma wysoki wynik w analizie.
| Wynik obserwacji | Możliwa interpretacja | Rozsądna reakcja |
|---|---|---|
| Termin często występuje u Ciebie i u konkurencji | To prawdopodobnie podstawowe słowo tematu | Sprawdź, czy jest użyte naturalnie i we właściwych miejscach |
| Termin często występuje u konkurencji, ale nie u Ciebie | Możliwy brak ważnego kontekstu | Oceń, czy warto dodać wyjaśnienie, przykład lub sekcję |
| Termin pojawia się u Ciebie znacznie częściej | Możliwe przeoptymalizowanie albo zbyt wąski temat | Usuń powtórzenia, zastąp je naturalnym językiem lub rozwiń treść |
| Termin ma wysoki wynik tylko na jednej stronie | Może wynikać z indywidualnego kąta artykułu | Nie kopiuj go bez sprawdzenia intencji i znaczenia |
Traktuję ten model jako narzędzie diagnostyczne, a nie generator gotowej listy słów. Google korzysta z wielu sygnałów, a współczesne systemy językowe potrafią rozumieć temat także wtedy, gdy tekst nie powtarza dokładnie tych samych wyrażeń co konkurencja.
Jak przeprowadzić analizę krok po kroku
Najpierw wybieram stronę lub zapytanie, dla którego tworzę treść, a potem analizuję kilka wyników o podobnej intencji. Nie wrzucam do jednego zestawu poradnika, kategorii sklepowej i strony usługowej, bo ich słownictwo wynika z różnych celów.
- Zdefiniuj intencję i wybierz 5-10 stron, które rzeczywiście odpowiadają na to samo zapytanie.
- Oczyść dane z menu, stopki, reklam i powtarzalnych elementów szablonu.
- Porównaj terminy, zwracając uwagę na słowa wspólne, brakujące i nadmiernie eksponowane.
- Pogrupuj pojęcia według tematów, na przykład definicje, narzędzia, błędy i zastosowania.
- Rozbuduj tekst tylko tam, gdzie dodatkowa informacja poprawi jego kompletność.
- Przeczytaj całość bez tabeli wyników i usuń fragmenty napisane wyłącznie po to, by zmieścić termin.
W praktyce największą wartość daje porównanie nie pojedynczych słów, ale całych grup znaczeniowych. Dla artykułu o analizie technicznej mogą to być między innymi „błędy indeksowania”, „robots.txt”, „sitemap” i „Google Search Console”. Taki zestaw mówi więcej niż ranking kilkudziesięciu oderwanych wyrazów.
Jeśli korzystasz z narzędzia automatycznego, sprawdź, jaki zbiór stron wykorzystuje do obliczeń. Wynik zależy od języka, liczby dokumentów, sposobu odmiany słów i tego, czy program analizuje pełną treść, czy tylko wybrane elementy strony. Nie istnieje jeden uniwersalny wynik, który byłby poprawny dla każdego artykułu.
TF-IDF a gęstość słów kluczowych
Gęstość słów kluczowych odpowiada na proste pytanie: jaki procent tekstu zajmuje dane słowo lub fraza. Analiza TF-IDF jest bardziej kontekstowa, ponieważ uwzględnia również występowanie terminu w innych dokumentach. Obie metody mogą więc prowadzić do innych wniosków.
Przykładowo artykuł może mieć wysoką częstotliwość frazy „pozycjonowanie stron”, ale nadal nie wyjaśniać linkowania, indeksowania ani intencji wyszukiwania. Z punktu widzenia czytelnika tekst będzie powtarzalny, mimo że jego główne słowo kluczowe pojawia się często.
| Cecha | Gęstość słów kluczowych | TF-IDF |
|---|---|---|
| Zakres analizy | Najczęściej jeden dokument | Dokument na tle całego zbioru |
| Główne pytanie | Jak często pojawia się termin? | Jak wyróżnia dokument na tle innych? |
| Największe ryzyko | Mechaniczne powtarzanie frazy | Ślepe kopiowanie słownictwa konkurencji |
| Zastosowanie | Kontrola oczywistych przesad | Analiza zakresu i kompletności tematu |
Moja ocena jest prosta: sama gęstość słów kluczowych ma dziś ograniczoną wartość, a TF-IDF również nie powinien być celem optymalizacji. Najlepszy tekst nie ma „idealnego wyniku”, tylko jasno odpowiada na pytanie, rozwija temat i prowadzi czytelnika do konkretnego wniosku.
Ograniczenia i najczęstsze błędy
Najczęstszy błąd polega na założeniu, że termin z wysokim wynikiem trzeba dopisać określoną liczbę razy. To szybko prowadzi do nienaturalnych zdań, powtórzeń i tekstu pisanego pod arkusz kalkulacyjny zamiast pod człowieka.
Nie traktuj wyniku jako czynnika rankingowego
TF-IDF jest modelem statystycznym, a nie publicznym miernikiem używanym jako samodzielny czynnik rankingowy. Nie znamy pełnego zbioru dokumentów, który miałby być podstawą obliczeń dla całej sieci, dlatego narzędzia SEO tworzą własne, ograniczone korpusy.
Uważaj na odmianę językową
W języku polskim jeden temat może pojawiać się w wielu formach gramatycznych. Program może potraktować „optymalizacja”, „optymalizacji” i „optymalizacją” jako osobne terminy, choć dla czytelnika są częścią tego samego pola znaczeniowego. Dlatego analiza automatyczna wymaga ręcznej interpretacji.
Przeczytaj również: PageRank w SEO - jak działa wartość linków?
Nie kopiuj słownictwa konkurencji bez kontekstu
Wysoki wynik pojedynczego słowa może być skutkiem specjalistycznego profilu jednej strony, a nie uniwersalnej potrzeby użytkownika. Zanim coś dodam, sprawdzam, czy termin pomaga wyjaśnić temat, odpowiada na dodatkowe pytanie albo ułatwia podjęcie decyzji.
Ograniczeniem jest także jakość tekstów w zbiorze. Jeżeli analizowane strony są krótkie, przestarzałe lub odpowiadają na inną intencję, otrzymasz precyzyjne obliczenia o małej wartości praktycznej. Dobre dane wejściowe są ważniejsze niż dokładność samego narzędzia.
Jak wykorzystać analizę bez pisania pod algorytm
Najlepiej użyć jej po przygotowaniu pierwszej wersji artykułu. Wtedy sprawdzasz, czy tekst obejmuje pojęcia, których czytelnik może potrzebować, zamiast budować całą treść wokół przewidywań narzędzia.
- Zaznacz terminy obecne u większości konkurentów i sprawdź, czy u Ciebie mają własne wyjaśnienie.
- Wyszukaj słowa występujące nadmiernie i przeczytaj akapity na głos.
- Zamień część powtórzeń na zaimki, odmianę gramatyczną albo bardziej precyzyjne określenia.
- Dodaj przykłady, liczby i konsekwencje zamiast kolejnych synonimów.
- Porównaj tekst z pytaniami odbiorcy, a dopiero później z raportem narzędzia.
Dobrym testem jest usunięcie wszystkich wyróżnionych terminów z raportu i ponowne przeczytanie artykułu. Jeśli nadal jest logiczny, konkretny i kompletny, analiza spełniła swoją rolę. Jeśli tekst rozpada się bez tych słów, prawdopodobnie został podporządkowany metryce zbyt mocno.
Największą wartością jest kompletność, nie idealny wynik
TF-IDF pomaga zobaczyć tekst z szerszej perspektywy. Pokazuje, które terminy wyróżniają dokument, jak wygląda jego słownictwo na tle konkurencji i gdzie może brakować ważnego kontekstu.
Nie traktowałbym jednak tej metody jako przepisu na pozycjonowanie. Używam jej raczej jako dodatkowej kontroli po analizie intencji, struktury i jakości odpowiedzi. Najlepszym efektem nie jest określony wynik liczbowy, lecz treść, po której czytelnik nie musi wracać do wyszukiwarki po podstawowe wyjaśnienia.