Klikasz „zapłać”, widzisz mapę na stronie albo logujesz się kontem Google i wszystko działa w kilka sekund. Za tymi pozornie prostymi funkcjami często stoi API, czyli sposób, w jaki różne programy wymieniają dane i uruchamiają swoje funkcje. Wyjaśnię, jak działa ten mechanizm, jakie są jego rodzaje, gdzie wykorzystuje się go na stronach WWW oraz na co uważać podczas integracji.
API łączy aplikacje i pozwala im współpracować bez ujawniania całego kodu
- API to zestaw reguł komunikacji między programami, systemami lub urządzeniami.
- W przypadku stron WWW komunikacja zwykle odbywa się przez HTTP lub HTTPS.
- Program wysyła żądanie do określonego endpointu, a serwer zwraca odpowiedź, często w formacie JSON.
- API obsługuje między innymi płatności, logowanie, mapy, pogodę, CMS-y i narzędzia AI.
- Bezpieczna integracja wymaga uwierzytelniania, limitów, dokumentacji i kontroli dostępu do danych.
Czym jest API i po co powstało
API to skrót od angielskiego Application Programming Interface, czyli interfejs programowania aplikacji. Najprościej mówiąc, jest to umówiony sposób komunikacji, dzięki któremu jeden program może poprosić drugi o dane albo wykonanie określonej operacji.
Nie trzeba przy tym znać wewnętrznej budowy drugiego systemu. Aplikacja nie musi wiedzieć, jak wygląda baza danych, jakie funkcje działają na serwerze ani w jakim języku napisano kod. Wystarczy, że zna zasady korzystania z interfejsu, czyli między innymi dostępne adresy, wymagane parametry oraz format odpowiedzi.
Dobrym porównaniem jest restauracja. Klient składa zamówienie kelnerowi, kelner przekazuje je do kuchni, a później przynosi gotowe danie. API pełni rolę kelnera. Przyjmuje żądanie, przekazuje je właściwemu systemowi i zwraca wynik, ale nie pozwala użytkownikowi wchodzić bezpośrednio do „kuchni”.
W praktyce API może działać lokalnie, na przykład jako część systemu operacyjnego lub biblioteki programistycznej. W świecie stron internetowych najczęściej mówi się jednak o Web API, które pozwala komunikować się aplikacjom działającym na różnych serwerach i urządzeniach.
API nie jest zwykłą wtyczką
Często spotykam się z przekonaniem, że API oznacza konkretny program do zainstalowania. To nieprecyzyjne uproszczenie. API jest przede wszystkim interfejsem i zestawem reguł, a do jego wykorzystania można potrzebować kodu, biblioteki, modułu albo wtyczki.
Nie jest też tym samym co interfejs graficzny. Użytkownik korzysta z przycisków, formularzy i menu, natomiast aplikacja korzysta z API. Oba interfejsy prowadzą do podobnego celu, ale są przeznaczone dla różnych odbiorców.
Jak działa komunikacja między aplikacjami
Typowa komunikacja internetowa opiera się na modelu żądanie-odpowiedź. Jedna aplikacja, nazywana klientem, wysyła żądanie do serwera udostępniającego API. Serwer sprawdza dane, wykonuje operację i odsyła odpowiedź.
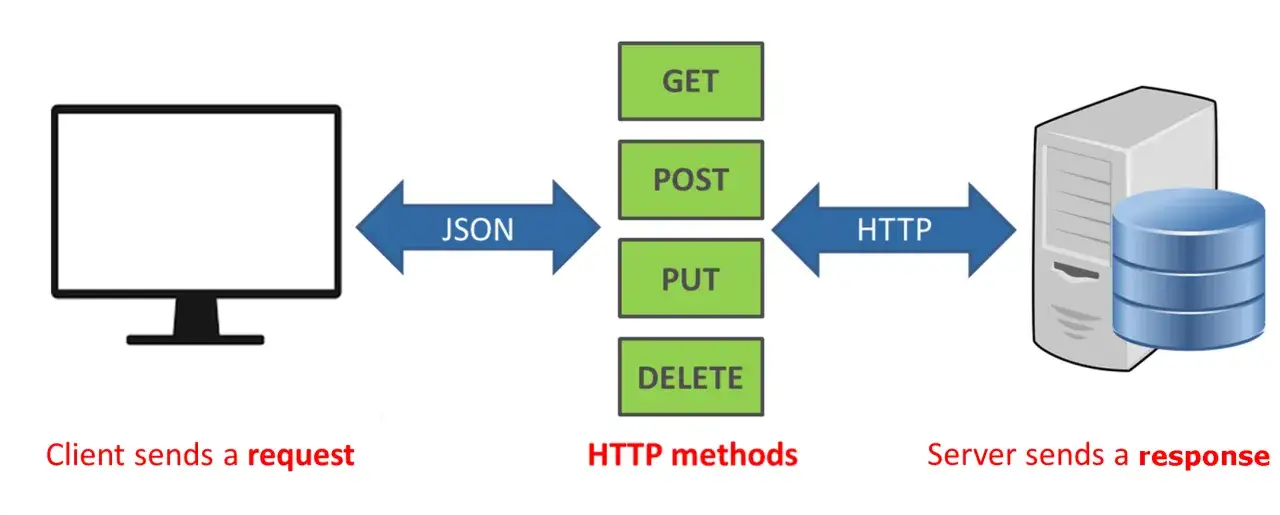
Żądanie trafia do konkretnego punktu dostępu, czyli endpointu. Endpoint można porównać do adresu konkretnego działu w systemie. Jeden może zwracać listę produktów, drugi szczegóły zamówienia, a trzeci umożliwia utworzenie płatności.
W przypadku popularnych API internetowych klient korzysta z metod HTTP. Ich znaczenie jest dość intuicyjne:
| Metoda | Typowe zastosowanie |
|---|---|
| GET | Pobieranie danych, na przykład listy produktów |
| POST | Tworzenie nowego zasobu lub wysłanie danych do przetworzenia |
| PUT | Pełna aktualizacja istniejącego zasobu |
| PATCH | Częściowa aktualizacja danych |
| DELETE | Usunięcie zasobu |
Odpowiedź zawiera dane oraz kod statusu. Kod z grupy 2xx zwykle oznacza powodzenie, kody 4xx wskazują problem po stronie żądania, a 5xx najczęściej oznaczają błąd serwera. Taki podział ułatwia diagnozowanie integracji, bo od razu wiadomo, czy problem dotyczy danych, uprawnień czy awarii usługi.
Dane są często przesyłane jako JSON, ponieważ ten format jest czytelny dla programów i stosunkowo łatwy do przetwarzania. Przykładowa odpowiedź może zawierać nazwę produktu, cenę, identyfikator oraz informację o dostępności. Człowiek nie musi jej oglądać bezpośrednio, ponieważ aplikacja zamienia ją na gotowy widok na stronie.
Prosty przykład działania
Załóżmy, że sklep internetowy ma pokazać aktualny koszt dostawy. Strona wysyła do API firmy kurierskiej dane o kodzie pocztowym, wadze paczki i wybranej metodzie dostawy. System kurierski oblicza cenę i odsyła wynik, który sklep wyświetla klientowi w formularzu.
To rozwiązanie jest wygodniejsze niż ręczne przepisywanie cenników. Trzeba jednak pamiętać, że sklep staje się zależny od dostępności zewnętrznego API. Gdy usługa nie działa, cena może się nie wyświetlić, dlatego dobrze zaprojektowany system powinien mieć komunikat awaryjny albo alternatywną ścieżkę.
Najważniejsze rodzaje API i różnice między nimi
API można dzielić według różnych kryteriów. Ze względu na dostęp wyróżnia się interfejsy publiczne, prywatne i partnerskie. Ze względu na sposób komunikacji mówi się między innymi o REST, GraphQL, SOAP oraz rozwiązaniach RPC.
| Rodzaj | Charakterystyka | Kiedy sprawdza się najlepiej |
|---|---|---|
| REST | Wykorzystuje HTTP i zasoby dostępne pod określonymi adresami | Strony WWW, aplikacje mobilne, sklepy internetowe |
| GraphQL | Klient sam określa, jakie pola chce otrzymać | Rozbudowane aplikacje, w których różne ekrany potrzebują innych danych |
| SOAP | Starszy, formalny standard oparty zwykle na XML | Systemy korporacyjne, bankowe i rozwiązania wymagające ścisłych kontraktów |
| RPC | Wywoływanie funkcji lub procedur dostępnych w innym systemie | Wewnętrzne usługi, mikroserwisy i komunikacja o wysokiej wydajności |
REST nie oznacza każdego API internetowego
REST jest bardzo popularny, ale nie jest synonimem każdego Web API. To styl projektowania, który porządkuje sposób udostępniania zasobów. W dobrze zaprojektowanym REST API adresy opisują zasoby, metody HTTP określają operacje, a odpowiedzi mają przewidywalną strukturę.
GraphQL działa inaczej. Zamiast pobierać z góry określoną odpowiedź, aplikacja wysyła zapytanie wskazujące potrzebne pola. Daje to większą elastyczność, ale wymaga bardziej świadomego projektowania i kontroli zapytań. W mojej ocenie REST nadal jest zwykle rozsądniejszym wyborem dla prostej integracji, natomiast GraphQL zyskuje przewagę przy dużych i wielokanałowych produktach.
Publiczne, prywatne i partnerskie interfejsy
Publiczne API jest dostępne dla zewnętrznych programistów, choć często wymaga rejestracji i klucza. Przykładem może być interfejs dostarczający dane o pogodzie albo kursach walut. Publiczne nie oznacza jednak całkowicie darmowe ani pozbawione limitów.
Prywatne API działa wewnątrz organizacji i łączy jej systemy, na przykład sklep, magazyn oraz program księgowy. Partnerskie API udostępnia funkcje wybranym firmom na podstawie umowy, określonych uprawnień i warunków korzystania.
Gdzie API jest używane na stronach WWW
API może być niewidoczne dla odwiedzającego, ale często odpowiada za najważniejsze funkcje serwisu. Kiedy strona pobiera dane z innego systemu, przetwarza płatność albo zapisuje formularz w CRM, prawdopodobnie korzysta z interfejsu programistycznego.
- Płatności online pozwalają sklepowi przekazać dane transakcji operatorowi i otrzymać informację o jej statusie.
- Logowanie zewnętrzne umożliwia korzystanie z konta w innym serwisie bez tworzenia osobnego hasła.
- Mapy i geolokalizacja dostarczają widok mapy, wyznaczanie trasy albo obliczanie odległości.
- Systemy CMS mogą przekazywać treści do strony, aplikacji mobilnej lub kilku różnych kanałów publikacji.
- Narzędzia marketingowe pobierają dane o kampaniach, konwersjach i odbiorcach, dzięki czemu raporty mogą powstawać automatycznie.
- Usługi AI przyjmują tekst, obraz lub inne dane i zwracają wygenerowaną odpowiedź, klasyfikację albo analizę.
Dobrym przykładem jest strona oparta na architekturze headless. Panel zarządzania treścią może działać niezależnie od warstwy wizualnej, a front-end pobiera artykuły przez API. Daje to swobodę technologiczną, ale wymaga większej dbałości o cache, obsługę błędów i wydajność niż klasyczna strona oparta na jednym systemie.
W SEO API może skrócić drogę od danych do decyzji. Automatyczny skrypt może pobierać informacje o widoczności, łączyć je z danymi analitycznymi i tworzyć raport. Samo podłączenie narzędzia nie poprawi jednak pozycji strony. API automatyzuje dostęp do danych, ale nadal trzeba poprawnie ustawić pomiar i wyciągać sensowne wnioski.
Bezpieczeństwo, limity i koszty korzystania z API
Najczęstszy błąd polega na traktowaniu API jak otwartego kanału bez żadnych ograniczeń. Dostęp powinien być kontrolowany za pomocą kluczy API, tokenów, sesji lub mechanizmów takich jak OAuth. Dane logowania i sekrety należy przechowywać po stronie serwera, a nie w kodzie JavaScript wysyłanym do przeglądarki.
Wrażliwe informacje powinny być przesyłane przez HTTPS, czyli szyfrowane połączenie. Trzeba też ograniczać uprawnienia. System obsługujący tylko odczyt produktów nie powinien otrzymywać prawa do usuwania zamówień ani zmiany danych klientów.
Właściciel API może stosować rate limit, czyli limit liczby żądań w określonym czasie. Przekroczenie limitu może zakończyć się czasową blokadą albo kodem 429. To ważne szczególnie przy automatyzacji, ponieważ źle napisany skrypt może wysłać setki lub tysiące niepotrzebnych zapytań.
Koszt zależy od dostawcy i skali użycia. Spotyka się bezpłatne plany z limitem, rozliczenie za liczbę żądań, abonament miesięczny oraz indywidualne umowy dla dużych firm. Przy planowaniu budżetu trzeba uwzględnić nie tylko opłatę za dostęp, lecz także koszt wdrożenia, monitoringu, utrzymania i obsługi awarii.
Przeczytaj również: Archiwum stron internetowych - jak odzyskać stare treści?
Na jakie ograniczenia trzeba się przygotować
- API może zmienić format odpowiedzi albo wycofać starszą wersję.
- Usługa zewnętrzna może mieć przerwy w działaniu lub ograniczoną wydajność.
- Dokumentacja może nie opisywać wszystkich wyjątków występujących w praktyce.
- Niektóre dane mogą podlegać ograniczeniom licencyjnym lub przepisom o ochronie danych.
- Integracja może uzależnić firmę od jednego dostawcy i utrudnić późniejszą zmianę systemu.
Dlatego nie traktuję integracji jako jednorazowego zadania programistycznego. Dobrze utrzymane API wymaga logów, alertów, testów i planu awaryjnego. Najwięcej problemów pojawia się nie podczas pierwszego połączenia, lecz kilka miesięcy później, gdy zmieni się wersja usługi albo wzrośnie liczba użytkowników.
Jak rozsądnie zacząć pracę z API
Na początku nie trzeba budować rozbudowanej architektury. Wystarczy przejść przez kilka konkretnych etapów i sprawdzić, czy dane połączenie rzeczywiście rozwiązuje problem biznesowy.
- Określ cel integracji. Zapisz, jakie dane mają być pobierane lub jakie działanie ma zostać wykonane.
- Przeczytaj dokumentację. Sprawdź endpointy, metody HTTP, wymagane parametry, format odpowiedzi i limity.
- Uzyskaj dostęp. Utwórz konto, wygeneruj klucz lub skonfiguruj odpowiedni mechanizm autoryzacji.
- Wykonaj testowe żądanie. Możesz użyć narzędzia do testowania API albo prostego skryptu, zanim podłączysz usługę do całej strony.
- Obsłuż błędy. Zaplanuj reakcję na brak danych, przekroczenie limitu, timeout i niedostępność serwera.
- Monitoruj działanie. Zbieraj informacje o czasie odpowiedzi, błędach i liczbie żądań.
Podczas testów sprawdzam przede wszystkim sytuacje nietypowe. Co stanie się, gdy użytkownik poda błędny adres? Jak zachowa się strona po wygaśnięciu tokenu? Czy klient zobaczy czytelny komunikat, gdy zewnętrzny system nie odpowie w ciągu kilku sekund?
Warto też ustalić, czy lepsze będzie pobieranie danych na żądanie, czy ich okresowe zapisywanie w pamięci podręcznej. Cache przechowuje wcześniej pobrane wyniki i zmniejsza liczbę zapytań, ale może sprawić, że użytkownik zobaczy dane nieco starsze. Wybór zależy od tego, czy liczy się aktualność co do sekundy, czy raczej szybkość i stabilność strony.
API nie należy mylić z webhookiem. W klasycznym modelu aplikacja pyta serwer, czy pojawiły się nowe dane. Webhook działa odwrotnie, ponieważ serwer sam wysyła powiadomienie, gdy wydarzy się określone zdarzenie, na przykład opłacenie zamówienia. Przy częstych aktualizacjach webhook może ograniczyć liczbę zbędnych zapytań.
API nie musi być skomplikowane, jeśli zacznie się od właściwego problemu
Najkrótsza odpowiedź na pytanie, czym jest API, brzmi następująco: to kontrolowany sposób, w jaki programy korzystają ze swoich danych i funkcji. Na stronie WWW może odpowiadać za płatność, mapę, logowanie, publikację treści albo automatyzację raportów.
Najważniejsze nie jest samo podłączenie popularnej usługi, lecz dopasowanie jej do celu, zabezpieczenie dostępu i przygotowanie na błędy. Mały testowy proces, dobra dokumentacja oraz monitoring zwykle dają więcej niż szybka integracja wykonana bez sprawdzenia limitów i warunków działania.